cuda_learning_01 CUDA 编程基础

cuda_learning_01

一、GPU 与 CUDA 结构
二、CUDA编程的要素
三、实践:PyTorch自定义CUDA算子

  内容主要来自知乎文章,CUDA(一):CUDA 编程基础,本文是学习笔记。

一、GPU 与 CUDA 结构

CPU 与 GPU

  对于处理器而言,有2个指标是最主要的:延迟和吞吐量。

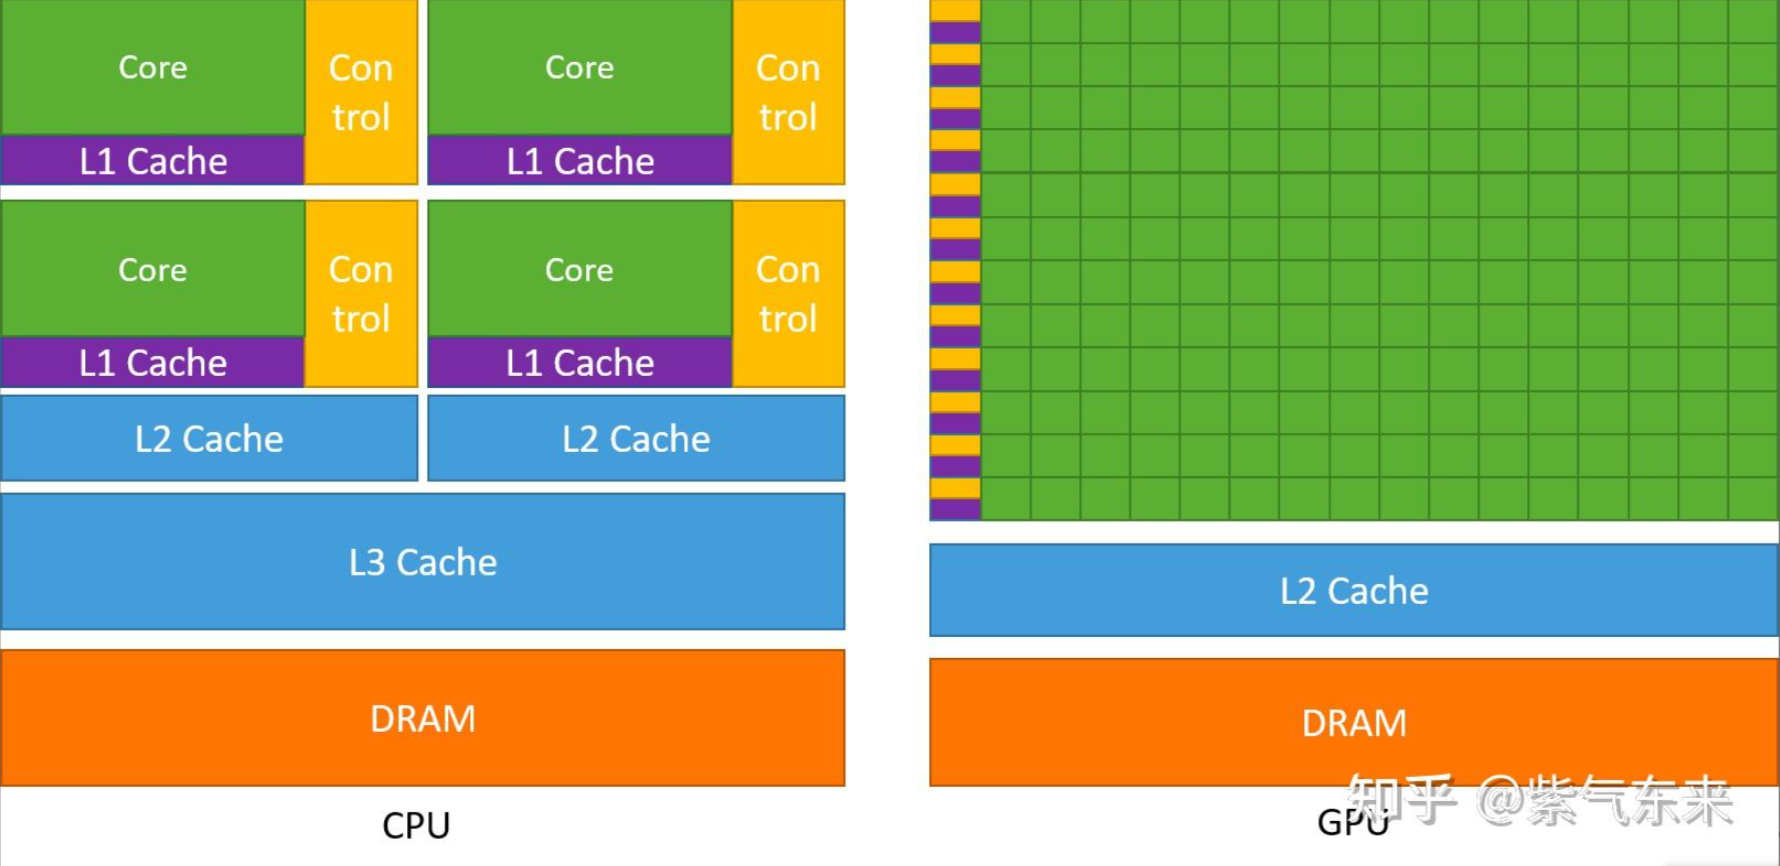
  下图左是 CPU 的示意图,有以下几个特点:

  1. CPU 中包含了多级高速的缓存结构。 这样提升了指令访问存储的速度。
  2. CPU 中包含了很多控制单元。 具体有2种,一个是分支预测机制,另一个是流水线前传机制。
  3. CPU 的运算单元 (Core) 强大,整型浮点型复杂运算速度快。

  基于以上三点,CPU 在设计时的导向就是减少指令的时延,被称之为延迟导向设计。

  下图右是 GPU 的示意图,有以下几个特点:

  1. GPU 中虽有缓存结构但是数量少。 因为要减少指令访问缓存的次数。
  2. GPU 中控制单元非常简单。 控制单元中没有分支预测机制和数据转发机制,对于复杂的指令运算就会比较慢。
  3. GPU 的运算单元 (Core) 非常多,采用长延时流水线以实现高吞吐量。 每一行的运算单元的控制器只有一个,意味着每一行的运算单元使用的指令是相同的,不同的是它们的数据内容。那么这种整齐划一的运算方式使得 GPU 对于那些控制简单但运算高效的指令的效率显著增加。

  基于此,可以看到 GPU 在设计过程中以一个原则为核心:增加简单指令的吞吐,这称 GPU 为吞吐导向设计。

image-20241130185858511

GPU vs CPU

CUDA结构

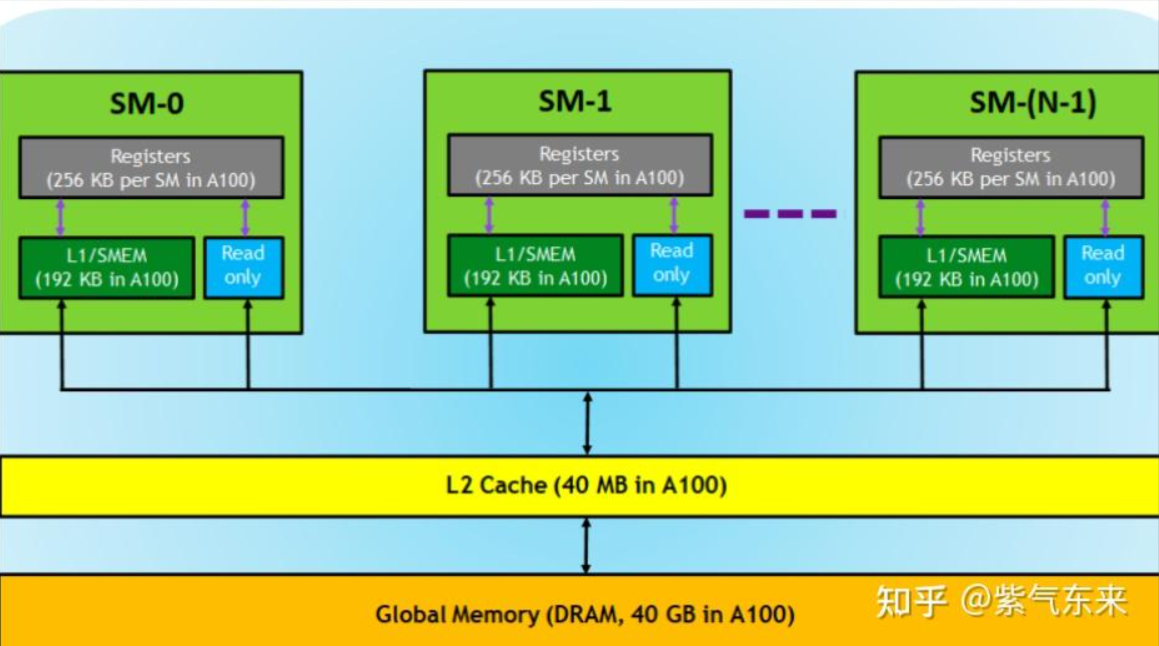
  从硬件的角度来讲,CUDA 内存模型的最基本的计算单位是 SP (线程处理器)。每个线程处理器 (SP) 都有自己的 registers (寄存器) 和 local memory (局部内存)。寄存器和局部内存只能被自己访问,不同的线程处理器之间彼此独立。

  多个线程处理器 (SP) 和一块共享内存构成 SM (多核处理器) (灰色部分)。多核处理器里边的多个线程处理器是互相并行的,是不互相影响的。每个多核处理器 (SM) 内都有自己的 shared memory (共享内存),shared memory 可以被线程块内所有线程访问。

  再往上,由这个 SM (多核处理器) 和一块全局内存,就构成了 GPU。一个 GPU 的所有 SM 共有一块 global memory (全局内存),不同线程块的线程都可使用。

  上面这段话可以表述为:每个 thread 都有自己的一份 register 和 local memory 的空间。同一个 block 中的每个 thread 则有共享的一份 share memory。此外,所有的 thread (包括不同 block 的 thread) 都共享一份 global memory。不同的 grid 则有各自的 global memory。

image-20241130212501862

CUDA 内存模型(硬件)

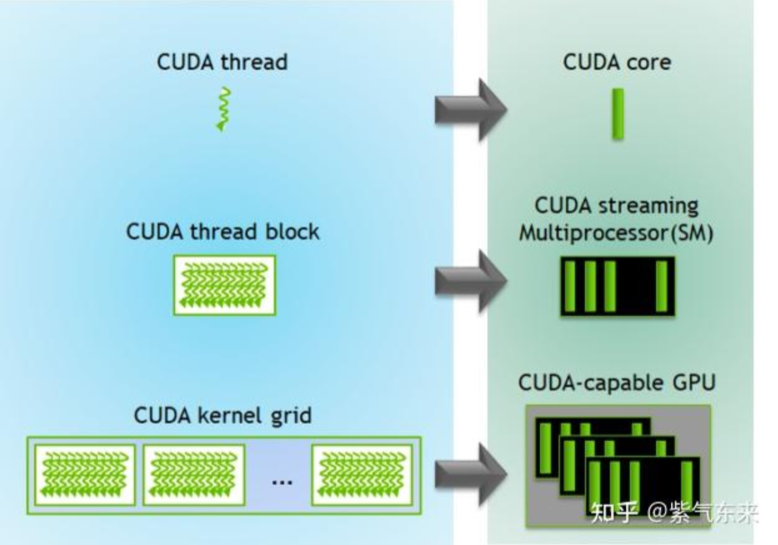
  从软件的角度来讲:

  1. 线程处理器 (SP) 对应线程 (thread)。
  2. 多核处理器 (SM) 对应线程块 (thread block)。
  3. 设备端 (device) 对应线程块组合体 (grid)。

关于SM, 线程块,share memory,线程束

  一个 线程块(Thread Block) 会被分配到一个 SM(Streaming Multiprocessor) 上执行。一个SM可以同时执行多个线程块,前提是该SM有足够的资源来容纳这些线程块(例如寄存器、共享内存等)。

  每个SM都有一块共享内存(Shared Memory),这块共享内存是所有在该SM上执行的线程块共享的,但线程块之间不能访问彼此的共享内存。在一个线程块内,所有线程共享该线程块的共享内存。

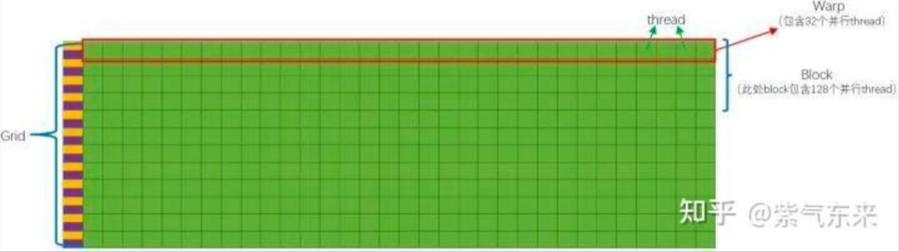
  GPU 的每一行由1个控制单元加上若干计算单元所组成,这些所有的计算单元执行的控制指令是一个。这是个非常典型的“单指令多数据流机制(SIMT)”,这一行称为一个线程束 (warp)。

  当线程块被划分到某个SM上时,它将进一步划分为多个线程束,因为线程束是SM的基本执行单元,但是一个SM同时并发的线程束数是有限的。这是因为资源限制,SM要为每个线程块分配共享内存,而也要为每个线程束中的线程分配独立的寄存器。所以SM的配置会影响其所支持的线程块和线程束并发数量。总之,就是网格和线程块只是逻辑划分,SM才是执行的物理层,一个kernel的所有线程其实在物理层是不一定同时并发的。所以kernel的grid和block的配置不同,性能会出现差异,这点是要特别注意的。还有,由于SM的基本执行单元是包含32个线程的线程束,所以block大小一般要设置为32的倍数。

image-20241130221814184

CUDA 内存模型(软件)

image-20241130225455580

  关于不同设备的硬件情况,手上只有自己的笔记本和实验室高贵的1080。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
	int dev = 0;
cudaDeviceProp devProp;
cudaGetDeviceProperties(&devProp, dev);
std::cout << "Using GPU device " << dev << ": " << devProp.name << std::endl;
std::cout << "Number of SMs: " << devProp.multiProcessorCount << std::endl;
std::cout << "Shared memory per block: " << devProp.sharedMemPerBlock / 1024.0 << " KB" << std::endl;
std::cout << "Max threads per block: " << devProp.maxThreadsPerBlock << std::endl;
std::cout << "Max threads per SM: " << devProp.maxThreadsPerMultiProcessor << std::endl;
std::cout << "Max thread warps per SM: " << devProp.maxThreadsPerMultiProcessor / 32 << std::endl;
/*
// 自己的笔记本
使用GPU device 0: NVIDIA GeForce MX350
SM的数量:5
每个线程块的共享内存大小:48 KB
每个线程块的最大线程数:1024
每个SM的最大线程数:2048
每个SM的最大线程束数:64

// 实验室高贵的一代神卡1080ti
Using GPU device 0: GeForce GTX 1080 Ti
Number of SMs: 28
Shared memory per block: 48 KB
Max threads per block: 1024
Max threads per SM: 2048
Max thread warps per SM: 64
*/

二、CUDA编程的要素

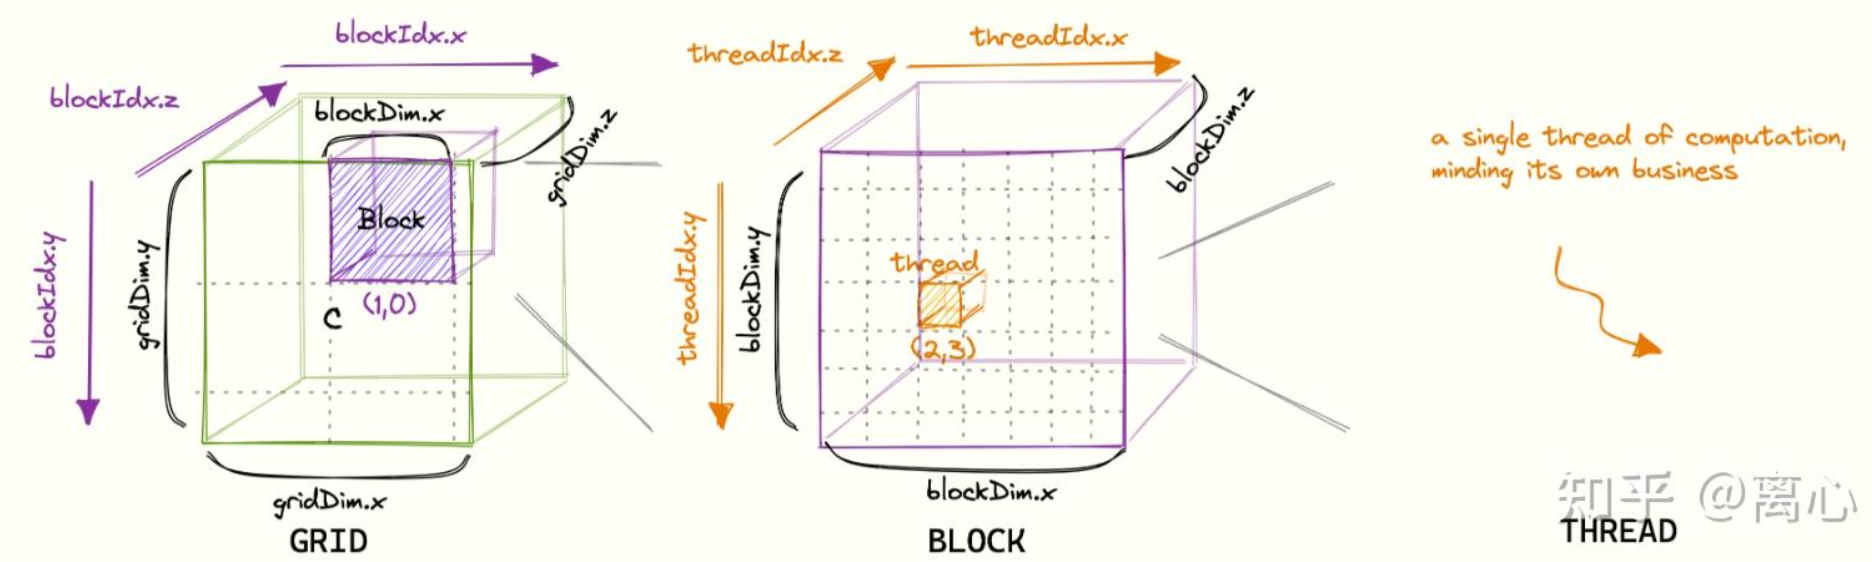
  一直困扰我的线程块的结构,我搞不太清队医一个大小为$(D_x,D_y)$的线程块,$D_x$指的是列数还是行数。目前看来应该是列数,即下图,图片来源,知乎@离心。

image-20241130223355252

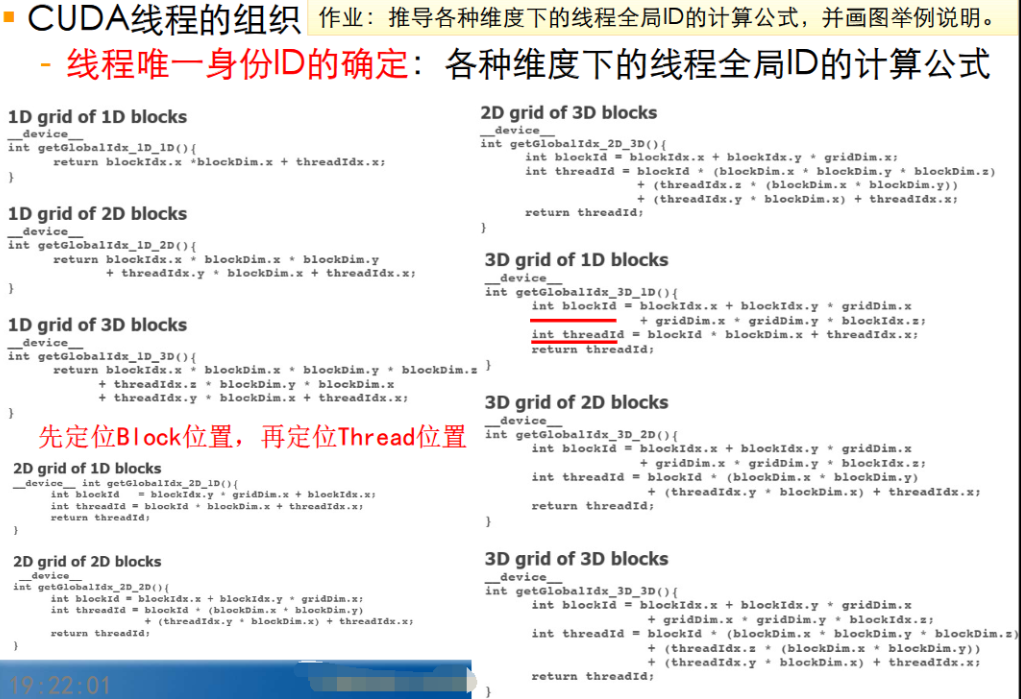
  明白了这个后,计算线程ID,就能推导了。

image-20241130224033938

三、实践:PyTorch自定义CUDA算子

  这部分使用 CUDA 定义一个简单的算子(两个矩阵相加),并将其绑定到pytorch上,然后通过run_time.py这个脚本计算执行时间。我们先着重学习绑定这个过程,可以通过有三种方法实现。简单来说就是pytorch不能调cuda的内核函数,需要一个接口,即我们将c++代码与pytorch代码绑定,调用pytorch代码即调用对应的c++代码。这部分案例主要参考github.com/godweiyang/NN-CUDA-Example和github.com/ifromeast/cuda_learning。

  Torch 使用CUDA 算子 主要分为三个步骤:

  • 先编写CUDA算子和对应的调用函数。
  • 然后编写torch cpp函数建立PyTorch和CUDA之间的联系,用pybind11封装。
  • 最后用PyTorch的cpp扩展库进行编译和调用。

  代码结构如下:

1
2
3
4
5
6
7
8
9
10
11
├── include 
│ └── add2.h # cuda算子的头文件
├── kernel
│ ├── add2_kernel.cu # cuda算子的具体实现
│ └── add2_ops.cpp # cuda算子的cpp torch封装
├── CMakeLists.txt
├── LICENSE
├── README.md
├── setup.py
├── run_time.py # 比较cuda算子和torch实现的时间差异
└── train.py # 使用cuda算子来训练模型

  代码实现:(可以当作模板)

1
2
3
4
5
// include/add2.h
void launch_add2(float *c,
const float *a,
const float *b,
int n);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// kernel/add2_kernel.cu
__global__ void MatAdd(float* c,
const float* a,
const float* b,
int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;
int j = blockIdx.y * blockDim.y + threadIdx.y;
int idx = j*n + i;
if (i < n && j < n)
c[idx] = a[idx] + b[idx];
}

void launch_add2(float* c,
const float* a,
const float* b,
int n)
{
dim3 block(16, 16);
dim3 grid(n/block.x, n/block.y);

MatAdd<<<grid, block>>>(c, a, b, n);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// kernel/add2_ops.cpp
#include <torch/extension.h>
#include "add2.h"

void torch_launch_add2(torch::Tensor &c,
const torch::Tensor &a,
const torch::Tensor &b,
int64_t n) {
launch_add2((float *)c.data_ptr(),
(const float *)a.data_ptr(),
(const float *)b.data_ptr(),
n);
}

PYBIND11_MODULE(TORCH_EXTENSION_NAME, m) {
m.def("torch_launch_add2",
&torch_launch_add2,
"add2 kernel warpper");
}

TORCH_LIBRARY(add2, m) {
m.def("torch_launch_add2", torch_launch_add2);
}

JIT 编译调用

  just-in-time(JIT, 即时编译),即 python 代码运行的时候再去编译cpp和cuda文件。

1
2
3
4
5
6
7
8
# 核心部分
from torch.utils.cpp_extension import load
cuda_module = load(name="add2",
extra_include_paths=["include"],
sources=["kernel/add2_ops.cpp", "kernel/add2_kernel.cu"],
verbose=True)

cuda_module.torch_launch_add2(cuda_c, a, b, n)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
# run_time.py
import time
import argparse # 导入argparse模块,用于命令行参数解析
import numpy as np
import torch
from torch.utils.cpp_extension import load

cuda_module = load(name="add2",
extra_include_paths=["include"],
sources=["kernel/add2_ops.cpp", "kernel/add2_kernel.cu"],
verbose=True)

# c = a + b (shape: [n * n])
n = 1024
a = torch.rand((n,n), device="cuda:0")
b = torch.rand((n,n), device="cuda:0")
cuda_c = torch.rand((n,n), device="cuda:0")

ntest = 10

# func是一个函数,这个类似c++传函数指针
def show_time(func):
times = list()
res = None
# 对GPU进行预热,避免首次运行时性能不稳定
for _ in range(10):
res = func()
for _ in range(ntest):
# 同步线程以获得准确的cuda运行时间
torch.cuda.synchronize(device="cuda:0")
# 第一个time是import的time,即模块名,第二个是函数名,返回当前时间的时间戳
start_time = time.time()
func()
torch.cuda.synchronize(device="cuda:0")
end_time = time.time()
times.append((end_time-start_time)*1e6)
return times, res

def run_cuda():
cuda_module.torch_launch_add2(cuda_c, a, b, n)
return cuda_c

def run_torch():
c = a + b
return c.contiguous() # 确保返回的结果在内存中是连续的

if __name__ == "__main__":

print("Running cuda...")
cuda_time, cuda_res = show_time(run_cuda)
print("Cuda time: {:.3f}us".format(np.mean(cuda_time)))
# np.mean() 返回算数平均值
# "{:.3f}"format 类似c++

print("Running torch...")
torch_time, torch_res = show_time(run_torch)
print("Torch time: {:.3f}us".format(np.mean(torch_time)))

torch.allclose(cuda_res, torch_res)
print("Kernel test passed.")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 执行如下命令即可
python run_time.py
# 运行结果
Using /home/xxx/.cache/torch_extensions as PyTorch extensions root...
Detected CUDA files, patching ldflags
Emitting ninja build file /home/xxx/.cache/torch_extensions/add2/build.ninja...
Building extension module add2...
Allowing ninja to set a default number of workers... (overridable by setting the environment variable MAX_JOBS=N)
Loading extension module add2...
Running cuda...
Cuda time: 53.453us
Running torch...
Torch time: 59.795us
Kernel test passed.

SETUP 编译调用

  第二种编译的方式是通过Setuptools,也就是编写setup.py,之后运行这个脚本。就可以将add2作为一个包添加到你的环境下,之后就可以像import numpy一样导入了,非常方便。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# setup.py
from setuptools import setup
from torch.utils.cpp_extension import BuildExtension, CUDAExtension

setup(
name="add2",
include_dirs=["include"],
ext_modules=[
CUDAExtension(
"add2",
["kernel/add2_ops.cpp", "kernel/add2_kernel.cu"],
)
],
cmdclass={
"build_ext": BuildExtension
}
)
1
2
3
4
5
# 执行如下命令安装
python setup.py install
# 执行结果
Processing dependencies for add2==0.0.0
Finished processing dependencies for add2==0.0.0
1
2
3
4
# python 代码中调用
import torch
import add2
add2.torch_launch_add2(c, a, b, n)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
# run_time.py
import time
import numpy as np
import torch
import add2

# c = a + b (shape: [n * n])
n = 1024
a = torch.rand((n,n), device="cuda:0")
b = torch.rand((n,n), device="cuda:0")
cuda_c = torch.rand((n,n), device="cuda:0")

ntest = 10

def show_time(func):
times = list()
res = None
for _ in range(10):
res = func()
for _ in range(ntest):

torch.cuda.synchronize(device="cuda:0")
start_time = time.time()
func()
torch.cuda.synchronize(device="cuda:0")
end_time = time.time()
times.append((end_time-start_time)*1e6)
return times, res

def run_cuda():
add2.torch_launch_add2(cuda_c, a, b, n)
return cuda_c

def run_torch():
c = a + b
return c.contiguous()

if __name__ == "__main__":

print("Running cuda...")
cuda_time, cuda_res = show_time(run_cuda)
print("Cuda time: {:.3f}us".format(np.mean(cuda_time)))

print("Running torch...")
torch_time, torch_res = show_time(run_torch)
print("Torch time: {:.3f}us".format(np.mean(torch_time)))

torch.allclose(cuda_res, torch_res)
print("Kernel test passed.")
1
2
3
4
5
6
# python run_time.py 运行结果
Running cuda...
Cuda time: 49.472us
Running torch...
Torch time: 61.989us
Kernel test passed.

CMAKE 编译调用

  逆天cmake,前两种方法都好用,就你给我报错是吧。受够了,我本来也不会cmake,之前用cmake就经常报错,懒得学了喵。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
# run_time.py 支持两种方法
# python run_time.py --compiler jit 或 python run_time.py --compiler setup
import time
import argparse
import numpy as np
import torch

# c = a + b (shape: [n * n])
n = 1024
a = torch.rand((n,n), device="cuda:0")
b = torch.rand((n,n), device="cuda:0")
cuda_c = torch.rand((n,n), device="cuda:0")

ntest = 10

def show_time(func):
times = list()
res = None
for _ in range(10):
res = func()
for _ in range(ntest):
torch.cuda.synchronize(device="cuda:0")
start_time = time.time()
func()
torch.cuda.synchronize(device="cuda:0")
end_time = time.time()
times.append((end_time-start_time)*1e6)
return times, res

def run_cuda():
if args.compiler == 'jit':
cuda_module.torch_launch_add2(cuda_c, a, b, n)
elif args.compiler == 'setup':
add2.torch_launch_add2(cuda_c, a, b, n)
else:
raise Exception("Type of cuda compiler must be one of jit/setup.")

return cuda_c

def run_torch():
c = a + b
return c.contiguous()

if __name__ == "__main__":
# parser 是 ArgumentParser 的一个实例,负责处理命令行输入的参数
parser = argparse.ArgumentParser()
# 向命令行解析器添加可选参数
parser.add_argument('--compiler', type=str, choices=['jit', 'setup'], default='jit')
# 返回一个包含所有命令行参数值的对象
args = parser.parse_args()

if args.compiler == 'jit':
from torch.utils.cpp_extension import load
cuda_module = load(name="add2",
extra_include_paths=["include"],
sources=["kernel/add2_ops.cpp", "kernel/add2_kernel.cu"],
verbose=True)
elif args.compiler == 'setup':
import add2
else:
raise Exception("Type of cuda compiler must be one of jit/setup.")
print("Running cuda...")
cuda_time, cuda_res = show_time(run_cuda)
print("Cuda time: {:.3f}us".format(np.mean(cuda_time)))

print("Running torch...")
torch_time, torch_res = show_time(run_torch)
print("Torch time: {:.3f}us".format(np.mean(torch_time)))

torch.allclose(cuda_res, torch_res)
print("Kernel test passed.")
1
2
python run_time.py --compiler setup
python run_time.py --compiler jit

  代码仓库:神秘链接。

参考资料